CoreDash vs Request Metrics
Request Metrics 是一款优秀的 RUM 工具,它的 Long Animation Frames 报告也是我见过最好的之一。CoreDash 是我做的,在积累了几个月的数据后,我依然觉得 CoreDash 是更好的选择,但对某些团队来说,Request Metrics 确实更合适。
Trusted by market leaders · Client results








谁在做 Request Metrics
Request Metrics 是 TrackJS 团队做的。Todd Gardner 和 Eric Brandes 做监控工具已经有些年头了。产品做得很干净,容易上手;发邮件联系支持,回复你的就是写这款产品的工程师。他们的客户经常夸这一点,就我对这款产品的了解来看,确实名副其实。
先声明一下:CoreDash 是我做的。Request Metrics 有些地方确实比 CoreDash 做得好,我都会如实指出来。度过最初几个月后,我依然认为 CoreDash 是更好的选择,但对某些团队来说,Request Metrics 才是最合适的工具。
Request Metrics 做得好的地方
主要是 Long Animation Frames。它有专门的 LoAF 仪表盘,可以把交互引起的帧与 script evaluation 引起的帧区分开,并按页面和脚本细拆,一路追查到具体执行的 event listener 或 setTimeout 回调。LoAF 还会标注在页面加载瀑布图里,放在这里看最说明问题。它甚至提供了一个 “Show Code” 按钮来直接调出内联脚本,省得你打开 DevTools(它拉取的是当前线上的脚本,所以刚发布之后,抓到的可能和当时实际运行的代码不一样)。如果你想了解 LoAF 是什么以及它为什么对 INP 至关重要,我在 corewebvitals.io 上写过一篇关于 Long Animation Frames API 的文章。
requestmetrics.com,2026 年 10 月。
它能做的不只是 RUM。从 2025 年 1 月开始,它每周都会对你访问量最大的页面运行桌面端和移动端的 Lighthouse 扫描;它还提供 CrUX 仪表盘,可以添加任何竞争对手的公开 origin。在还没安装任何脚本之前扫描就会启动,第一天就有数据可看。如果是 Professional 方案,光靠同一段脚本,你还能拿到 JavaScript 错误监控、API 监控、流量分析、漏斗和 session timeline。
归因做得很扎实。LCP 和 CLS 元素直接提供 CSS selector,复制就能贴进 DevTools;客户端 agent 还会采集 TTFB 以及 LCP 各个子阶段(resource load delay、load time 和 render delay)。
隐私处理得很得当:不用 cookie,IP 地址加盐哈希后直接丢弃,数据存储在加拿大;Enterprise 客户支持自托管或使用独立实例。安装也很方便,提供 CDN 代码片段或 NPM 模块,且兼容服务端渲染。你还可以把 collector 路由到自己的域名下,防止广告拦截插件吞掉 beacon。能替你考虑这点的工具不多,而 beacon 丢失确实是个头疼的真问题。
收费清晰可预期。有免费方案;Essentials 方案按年付起步价每月 34 美元,不限用户数;而且绝不会产生超额账单。
如果你已经在使用 Request Metrics
那说明你已经在采集真实访客的数据了,而我审计过的大多数网站都还没做到。它们往往只看 Lighthouse 跑分,或者 Search Console 里只显示 URL 分组的报告。有 RUM 总比没有强,Request Metrics 已经算是不错的选择。
如果它能解答你想了解的问题,那就继续用。更换 RUM 工具既会丢失历史数据,还得搭上一周的精力;只有当手头的工具再也给不出答案时,换工具才值得。对很多团队来说,这往往发生在后期——容易解决的问题都搞定之后,剩下的硬骨头只会越来越难啃。
CoreDash 与 Request Metrics 快速对比
价格与功能核对时间为 2026 年 9 月。
| CoreDash | Request Metrics | |
|---|---|---|
| 定位 | Core Web Vitals RUM | RUM、Lighthouse 和 CrUX,Professional 方案还包含错误、分析与 API 监控 |
| Collector 体积 | 小于 2KB | Gzip 后约 13KB(包含错误与网络监控) |
| LCP 归因 | 元素、元素类型、图片 URL、preload/lazy load 状态、四个阶段 | 元素选择器、图片 URL、采集子阶段数据 |
| INP 归因 | 元素、输入类型、加载状态、input delay / processing / presentation、LoAF 脚本 URL | 元素选择器、事件类型、加载状态 |
| Long Animation Frames | 支持将脚本 URL 作为维度过滤 INP | 独立仪表盘、invocation vs evaluation、支持按页面与按脚本出报告 |
| CrUX | CrUX 数据对照 | 带有竞对 origin 的 CrUX 仪表盘 |
| Lab 测试 | CI 中的发布前检查、合成监控 | 每周 Lighthouse 扫描(桌面端与移动端)、支持按需运行 |
| 数据导出 | API,所有方案均提供面向 Claude、Cursor 等 Agent 的 MCP server | CSV 导出 |
| 告警 | 邮件和 Slack,支持自定义及 AI 自动告警 | 邮件通知 |
| 数据保留 | 6 个月到 8 年 | 24 小时(Free)、30 天(Essentials)、90 天(Professional) |
| 流量限制 | 按方案每月分配 PV,可加购流量包 | 按分钟限流,超出上限的 PV 直接丢弃 |
| 入门价格(年付) | $16/月:7.5 万 PV、1 个站点、3 个用户 | Free:1K PV、24 小时保留。$34/月:7.5 万 PV、不限用户数 |
| 约 50 万 PV(年付) | Standard 方案,$31/月,保留 1 年 | Professional 方案,$88/月,保留 90 天 |
| Agency 支持 | 带 Master Key 的 Agency API,共享 PV 额度,不支持白标 | Professional 方案提供白标报告 |
| 数据存储地 | 欧盟(EU) | 加拿大,Enterprise 方案支持私有化部署或独立实例 |
到了后期,CoreDash 强在哪里
数据保留时长
Request Metrics 的 Essentials 方案保留 30 天,Professional 方案保留 90 天。这足够抓住上周发布引入的 regression,但回答不了 “我们比去年 11 月变快了吗?”——每年黑五过后,总会有人问这句。而 CoreDash 的 Starter 方案保留 6 个月,Standard 方案 1 年,Studio 方案 3 年,Enterprise 方案 8 年。
流量限制的机制也不同。Request Metrics 按每分钟计量容量,超出限额的 PV 直接丢弃。他们对此很坦诚,这也是他们能承诺绝无意外账单的做法,其官方文档建议购买预估流量 1.5 到 2 倍的容量。平时你基本感觉不到。但遇到大促日,流量峰值就会被直接丢掉,而那恰恰是你最想看数据的一个小时。
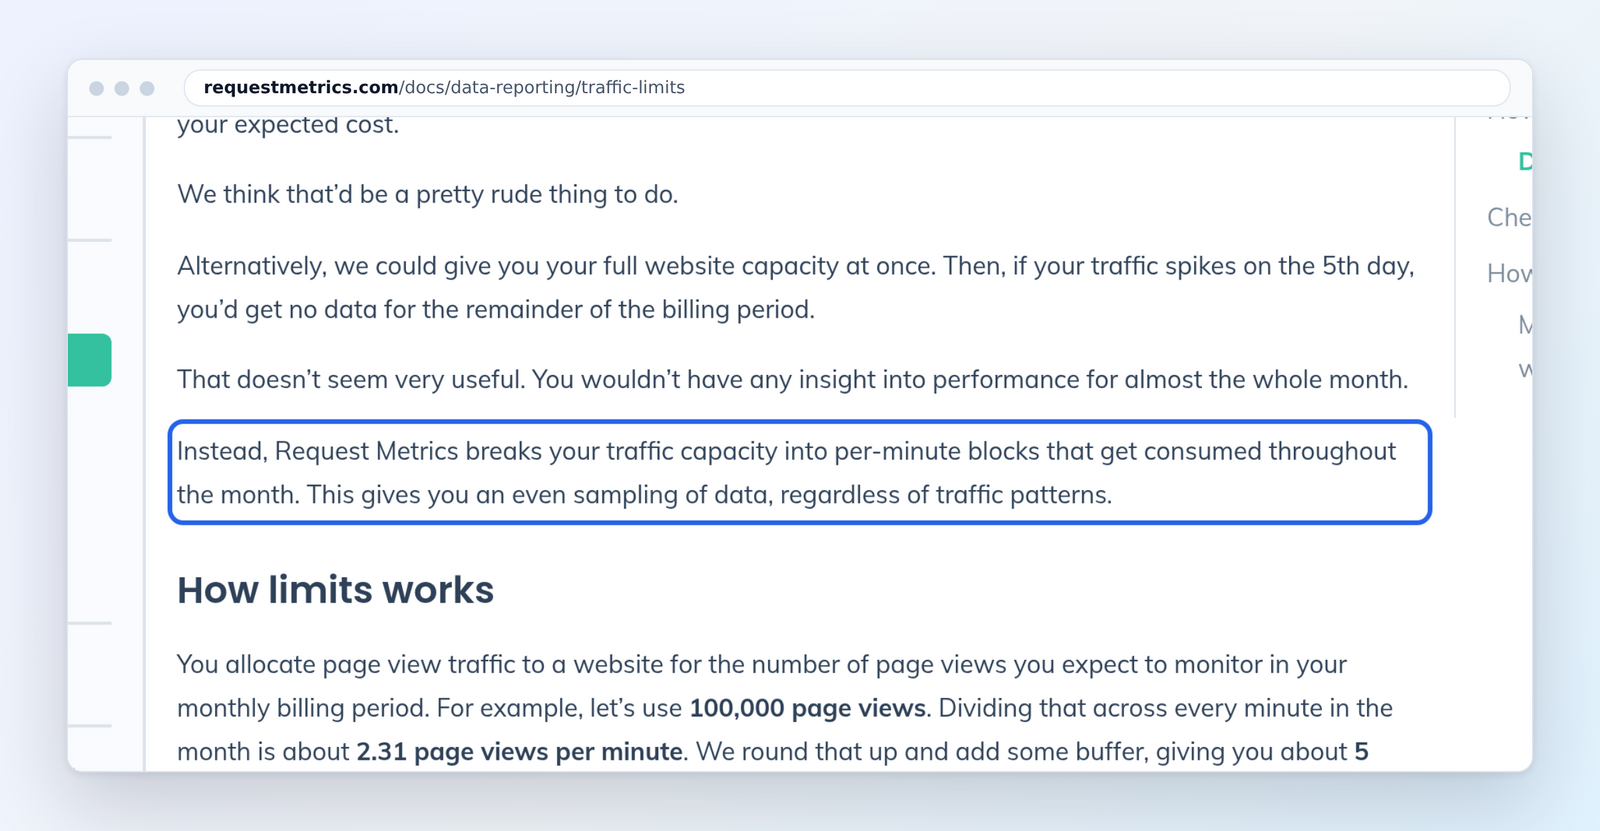
Request Metrics 流量限制文档,2026 年 10 月。
随着流量增加,价格差距还会进一步拉大。每月 50 万 PV 左右时,Request Metrics Professional 按年付算下来是每月 88 美元,保留 90 天历史数据。CoreDash Standard 只要 31 美元,保留 1 年数据。平心而论,Professional 还提供了错误监控、漏斗和分析功能(这些 CoreDash 没有),并且不限用户数(Standard 限制 10 个用户)。在 CoreDash 上,你只需为 PV 和保留时长付费,所有方案都能使用全部仪表盘。
INP 各阶段拆解
Request Metrics 会告诉你触发 INP 的是哪个元素、是键盘事件还是 pointer 事件,以及当时页面是否仍在加载。这很有用,但也就到此为止了。CoreDash 还会把每一次 INP 细分为 input delay、processing 和 presentation,并关联 LoAF 脚本 URL、input type 以及 load state。分清阶段,才知道该修哪里。input delay 长,说明访客点击时有其他东西占用了 main thread,通常是 tag manager 或 consent 脚本。processing 长,说明你自己的 handler 执行慢。presentation 长,说明后续的 render 工作量太大。两个 INP 相同的页面,需要的修复手段可能完全不同,往往连负责的团队都不一样。
我在 Request Metrics 的文档里没找到 INP 各阶段拆解的内容(他们目前还没有 INP 指南)。如果 INP 是你的主要痛点,建议在他们的试用期里重点确认这一点。
在 LCP 上两者的差距要小一些,Request Metrics 也会采集各个子阶段。CoreDash 则补齐了元素类型,以及 LCP 图片是经过了 preload 还是 lazy loading——遇到 LCP 慢,这是我首先排查的事情之一。随后 Diagnosis 仪表盘会针对你的技术栈直接给出修复方案。
你的 AI Agent 可以直接读取 field data
对我来说,这是最大的区别。我在 Request Metrics 里没找到用于读取性能数据的公开 API。他们文档里的 API 指的是往里发送数据的 browser agent API,数据要取出来只能靠 CSV 导出。不过他们在 AI 上动手很早:早在 2023 年,他们就推出了基于 ChatGPT 的助手 Professor Sloth,内置在仪表盘里。
CoreDash 提供了一个只读 API,并在同一端点上提供了 MCP server。所有方案都包含 MCP server,Starter 方案也不例外。把它作为自定义连接器添加到 Claude,或者接入 Claude Code、Cursor、Windsurf、VS Code、Gemini CLI,你的 Agent 就能自行查询 field data。比如让它查:结账流程在移动端的 p75 LCP,按 LCP 元素分组,对比上周数据。
我还开发了 CWV Superpowers,这是一个采用 MIT 协议的免费 Agent。它能找出你 CoreDash 数据中最严重的瓶颈,对该页面运行 Chrome trace,并直接返回代码修复方案(具体到文件、行号和 diff)或一份 HTML 报告。它根本不看 Lighthouse 跑分。具体如何运作,我写过一篇关于用 AI Agent 修复 INP 的文章。
我自己的很多调试工作,起手式都是让 Agent 去向 field data 提问。如果数据只能导出成 CSV,那无论仪表盘做得多好,Agent 都什么也问不了。
Agency 支持
Request Metrics 在 Professional 方案中为 Agency 提供了白标报告,方便你用自己的品牌向客户发报告。CoreDash 不做白标,但 Agency API 会给你一个 master key,用于创建、更新和删除客户项目,并跨所有项目读取数据。所有客户共享 PV 额度池,统一开一张发票。你做你自己的报告界面,CoreDash 负责供应数据。参见 Agency 定价。
什么时候该选 Request Metrics
- 你想用一段脚本在一个工具里搞定 RUM、JavaScript 错误、API 监控和漏斗。错误监控来自做这个很多年的 TrackJS 团队。
- 你的大部分精力都在排查 Long Animation Frames,想要一个专门的 LoAF 仪表盘。
- 你需要给客户出白标报告。
- 你的数据必须留在加拿大,或者需要自托管、独立实例。
- 你的站点规模小,免费方案就够用;或者团队在入门方案中就需要不限用户数。
- 你想在安装任何脚本之前,第一天就拿到 Lighthouse 扫描和竞争对手的 CrUX 数据。
在自己的网站上实测一下
最简单的对比办法,就是把两个都挂上去跑两周。两个脚本都异步(async)加载,互不干扰。CoreDash 提供 14 天试用且无需信用卡,用一个 script 标签或 WordPress 插件就能完成安装。查看定价方案,或者预约 20 分钟 Demo,我来带你一起梳理你的实际数据。
如需了解其他工具,请看全部 CoreDash 对比评测。
资料来源:Request Metrics 定价、定价文档、流量限制、LoAF 指南、LCP 指南、CrUX 指南、browser agent API 参考、最终用户数据、Unified Web Performance 发布说明、Professor Sloth 发布公告。Agent 体积基于 rm.js v2.4.1 测得。