CoreDash vs Request Metrics
Request Metrics to dobre narzędzie RUM, a raportowanie Long Animation Frames ma jedno z najlepszych, jakie widziałem. Zbudowałem CoreDash i po kilku miesiącach zbierania danych nadal uważam je za lepszy wybór, ale niektórym zespołom lepiej podpasuje Request Metrics.
Trusted by market leaders · Client results








Kto tworzy Request Metrics
Request Metrics tworzą ludzie stojący za TrackJS. Todd Gardner i Eric Brandes budują narzędzia do monitoringu od lat. Produkt jest przejrzysty i prosty w obsłudze, a gdy napiszesz do supportu, odpowiadają inżynierowie, którzy go stworzyli. Klienci często to podkreślają i patrząc na narzędzie, w pełni w to wierzę.
Stworzyłem CoreDash, miej to na uwadze. Request Metrics robi pewne rzeczy lepiej niż CoreDash i otwarcie je wskażę. Po pierwszych miesiącach CoreDash nadal uważam za lepszy wybór, ale dla części zespołów to Request Metrics będzie właściwym narzędziem.
Co Request Metrics robi dobrze
Przede wszystkim Long Animation Frames. Jest tu osobny dashboard LoAF, w którym można oddzielić klatki wywołane interakcjami od tych wynikających z ewaluacji skryptów. Można je też analizować w rozbiciu na strony i skrypty – aż do konkretnego event listenera czy callbacku setTimeout, który się wykonał. Klatki LoAF trafiają też na waterfall ładowania strony, czyli dokładnie tam, gdzie mają największy sens. Jest nawet przycisk „Show Code”, który wyświetla skrypt inline, więc nie trzeba otwierać DevTools (pobiera skrypt w wersji produkcyjnej z danego momentu, więc tuż po deployu może różnić się od kodu, który faktycznie się wykonał). Jeśli chcesz wiedzieć, czym jest LoAF i dlaczego ma znaczenie dla INP, napisałem o Long Animation Frames API na corewebvitals.io.
requestmetrics.com, październik 2026.
Narzędzie potrafi też więcej niż sam RUM. Od stycznia 2025 roku wykonuje cotygodniowe skany Lighthouse na desktopie i mobile dla podstron o największym ruchu, a w dashboardzie CrUX można dodać dowolną domenę konkurencji. Skany ruszają, zanim cokolwiek zainstalujesz, więc od pierwszego dnia masz na czym pracować. W planie Professional dochodzi jeszcze monitoring błędów JavaScript, monitoring API, analityka ruchu, lejki i osie czasu sesji – wszystko z jednego skryptu.
Atrybucja wypada dobrze. Elementy LCP i CLS dostajesz jako selektory CSS do wklejenia wprost do DevTools, a agent obok TTFB zbiera też składowe LCP (resource load delay, czas ładowania i render delay).
Kwestie prywatności są rozwiązane porządnie: żadnych ciasteczek, adresy IP są haszowane z solą i od razu usuwane, dane trafiają do Kanady, a klienci Enterprise mogą wybrać self-hosting lub instancję na wyłączność. Instalacja jest prosta – wystarczy snippet z CDN albo moduł NPM. Kod działa bezpiecznie z server side renderingiem, a ruch do kolektora można puścić przez własną domenę, żeby adblockery nie wycinały beaconów. Niewiele narzędzi w tym pomaga, a gubienie beaconów to realny problem.
Cennik jest przewidywalny. Dostępny jest plan darmowy, Essentials zaczyna się od 34 $ miesięcznie przy rozliczeniu rocznym bez limitu użytkowników i nie ma tu żadnych dopłat za przekroczenie limitu.
Jeśli już korzystasz z Request Metrics
Mierzysz już rzeczywistych użytkowników – a większość stron, które audytuję, w ogóle tego nie robi. Bazują na wynikach z Lighthouse i raporcie z Search Console, który pokazuje tylko grupy URL-i. Jakikolwiek monitoring rzeczywistych użytkowników jest lepszy niż żaden, a Request Metrics jest pod tym względem dobre.
Jeśli odpowiada na zadawane pytania, zostań przy nim. Zmiana narzędzia RUM oznacza utratę historii i tydzień pracy, więc ma sens dopiero wtedy, gdy obecne przestaje dawać odpowiedzi. W wielu zespołach ten moment przychodzi później – gdy najprostsze poprawki są już wdrożone, a pytania stają się trudniejsze.
CoreDash vs Request Metrics w skrócie
Ceny i funkcje sprawdzone we wrześniu 2026.
| CoreDash | Request Metrics | |
|---|---|---|
| Główny nacisk | Core Web Vitals RUM | RUM, Lighthouse i CrUX; w planie Professional dodatkowo błędy, analityka i monitoring API |
| Rozmiar kolektora | Poniżej 2 KB | Około 13 KB gzipped (obejmuje śledzenie błędów i sieci) |
| Atrybucja LCP | Element, typ elementu, URL obrazu, status preload/lazy loading, cztery fazy | Selektor elementu, URL obrazu, zebrane składowe |
| Atrybucja INP | Element, input type, load state, input delay / processing / presentation, URL skryptu LoAF | Selektor elementu, event type, load state |
| Long Animation Frames | URL skryptu jako wymiar do filtrowania INP | Osobny dashboard, invocation vs evaluation, raporty per strona i per skrypt |
| CrUX | Korelacja z danymi CrUX | Dashboard CrUX z domenami konkurencji |
| Testy laboratoryjne | Weryfikacja pre-deploy w CI, monitoring syntetyczny | Cotygodniowe skany Lighthouse (desktop i mobile), uruchamianie na żądanie |
| Eksport danych | API oraz serwer MCP w każdym planie dla Claude, Cursor i innych agentów | Eksport do CSV |
| Alerty | E-mail i Slack, alerty własne oraz automatyczne alerty AI | Powiadomienia e-mail |
| Retencja danych | Od 6 miesięcy do 8 lat | 24 godziny (Free), 30 dni (Essentials), 90 dni (Professional) |
| Limity ruchu | Miesięczna liczba odsłon zależna od planu, pakiety dodatkowe | Rozliczanie minutowe, odsłony ponad limit są odrzucane |
| Cena początkowa (rocznie) | 16 $/mies.: 75 tys. odsłon, 1 strona, 3 użytkowników | Free: 1 tys. odsłon, retencja 24 h. 34 $/mies.: 75 tys. odsłon, bez limitu użytkowników |
| Około 500 tys. odsłon (rocznie) | Standard, 31 $/mies., 1 rok retencji | Professional, 88 $/mies., 90 dni retencji |
| Agencje | Agency API z kluczem głównym, wspólna pula odsłon, bez white-label | Raporty white-label w planie Professional |
| Lokalizacja danych | UE | Kanada, w planie Enterprise self-hosting lub instancja na wyłączność |
Gdzie CoreDash z czasem wysuwa się na prowadzenie
Jak długo przechowujesz dane
Request Metrics przechowuje dane przez 30 dni w planie Essentials i 90 dni w Professional. To wystarczy, żeby wyłapać regresję po deployu z zeszłego tygodnia, ale nie odpowie na pytanie: „czy strona działa szybciej niż w zeszłym listopadzie?”, które po Black Friday pada zawsze. CoreDash przechowuje dane przez 6 miesięcy w planie Starter, rok w Standard, 3 lata w Studio i 8 lat w Enterprise.
Inaczej wyglądają też limity ruchu. Request Metrics rozlicza przepustowość w ujęciu minutowym i odrzuca odsłony ponad limit. Mówią o tym wprost – dzięki temu gwarantują, że nie dostaniesz niespodziewanego rachunku, a w dokumentacji sugerują zakup planu na 1,5 do 2 razy większy ruch niż prognozowany. Na co dzień tego nie widać. Ale w trakcie dużej wyprzedaży szczyt ruchu przepada – a to dokładnie ta godzina, na której najbardziej ci zależy.
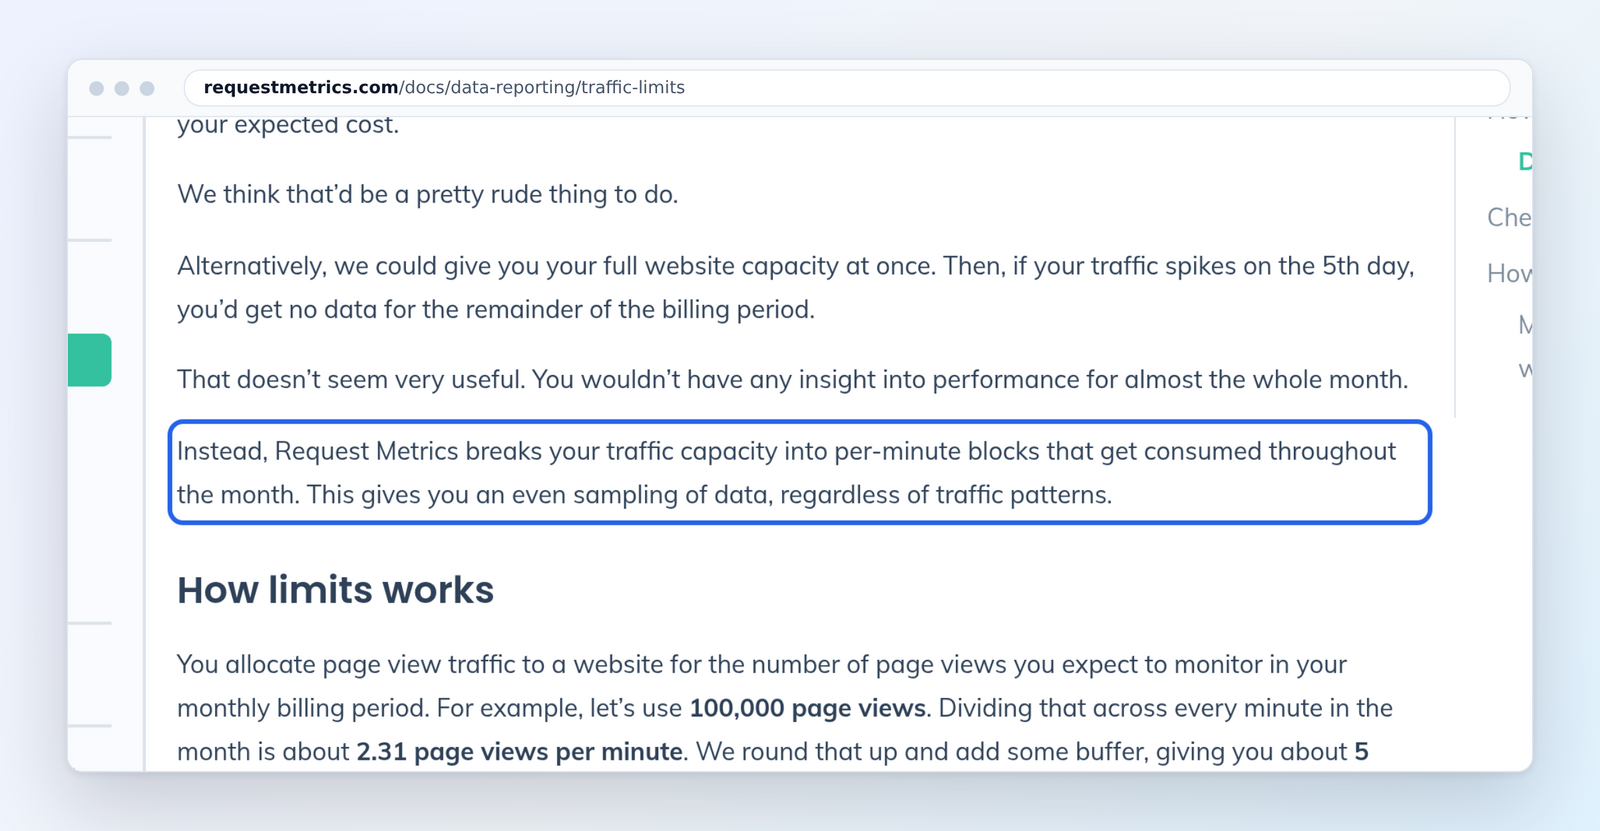
Dokumentacja Request Metrics dotycząca limitów ruchu, październik 2026.
A różnica w cenie rośnie wraz z ruchem. Przy około 500 000 odsłon miesięcznie Request Metrics Professional kosztuje 88 $ miesięcznie przy rozliczeniu rocznym i daje 90 dni historii. CoreDash Standard kosztuje 31 $ z rokiem historii. Trzeba uczciwie przyznać, że w planie Professional dostajesz też monitoring błędów, lejki i analitykę, których CoreDash nie ma, oraz nielimitowaną liczbę użytkowników (Standard ma limit 10). W CoreDash płacisz za odsłony i retencję, a każdy plan ma dostęp do wszystkich dashboardów.
Fazy INP
Request Metrics podaje, który element był celem INP, czy event pochodził z klawiatury, czy ze wskaźnika oraz czy strona wciąż się ładowała. Przydatne, ale na tym koniec. CoreDash dzieli też każdy INP na input delay, processing i presentation, łącząc go z URL-em skryptu LoAF, input type i load state. Fazy od razu wskazują, co trzeba naprawić. Długi input delay oznacza, że gdy użytkownik kliknął, coś innego blokowało main thread – zazwyczaj tag manager albo skrypt zgody na cookies. Długi processing oznacza, że własny handler wykonuje się za wolno. Długi presentation oznacza, że render po interakcji jest zbyt duży. Dwie strony z identycznym INP mogą wymagać zupełnie innego fixa – i często zaangażowania zupełnie innego zespołu.
W dokumentacji Request Metrics nie udało mi się znaleźć podziału na fazy INP (nie mają jeszcze przewodnika po INP). Jeśli to INP jest u ciebie głównym problemem, sprawdź to w trakcie ich okresu próbnego.
Przy LCP różnica jest mniejsza – Request Metrics również zbiera poszczególne składowe. CoreDash dokłada do tego typ elementu oraz informację, czy obraz LCP był preładowany, czy miał ustawiony lazy loading – a to jedna z pierwszych rzeczy, które sprawdzam przy wolnym LCP. W dashboardzie Diagnosis dostajesz od razu gotowego fixa dopasowanego do twojego stacku.
Agent AI może czytać field data
Dla mnie to największa różnica. W Request Metrics nie znalazłem publicznego API do odczytu danych o wydajności. API opisywane w ich dokumentacji to API agenta przeglądarkowego służące do wysyłania danych, a sam eksport odbywa się przez pliki CSV. Byli jednak jednymi z pierwszych, jeśli chodzi o AI: już w 2023 roku wprowadzili asystenta bazującego na ChatGPT o nazwie Professor Sloth, który działa wewnątrz ich dashboardu.
CoreDash udostępnia read-only API oraz serwer MCP na tym samym endpoincie. Serwer MCP jest w każdym planie, również w Starterze. Dodajesz go do Claude jako custom connector albo do Claude Code, Cursor, Windsurf, VS Code czy Gemini CLI – i agent sam odpytuje field data. Na przykład: podaj p75 LCP na mobile dla ścieżki checkoutu, pogrupowane po elemencie LCP, w porównaniu z zeszłym tygodniem.
Stworzyłem też CWV Superpowers – darmowego agenta na licencji MIT. Wyszukuje największe wąskie gardło w danych CoreDash, odpala Chrome trace dla tej strony i zwraca gotową poprawkę w kodzie (plik, linia i diff) albo raport w HTML. Nigdy nie zagląda do wyniku Lighthouse. O tym, jak to działa, pisałem w artykule o naprawianiu INP przy pomocy agenta AI.
Sam zaczynam większość debugowania od tego, że agent odpytuje field data. Jeśli dane można wyciągnąć tylko w CSV, agent o nic nie zapyta – bez względu na to, jak dobre są dashboardy.
Agencje
W planie Professional Request Metrics oferuje agencjom raporty white-label – przydatna rzecz, jeśli chcesz wysyłać klientom raporty pod własnym brandem. CoreDash nie ma opcji white-label. Zamiast tego Agency API daje master key, którym tworzysz, aktualizujesz i usuwasz projekty klientów oraz czytasz dane ze wszystkich naraz. Odsłony trafiają do wspólnej puli dla wszystkich klientów, a faktura jest jedna. Budujesz własne raportowanie, a CoreDash dostarcza dane. Sprawdź cennik dla agencji.
Kiedy lepiej wybrać Request Metrics
- Szukasz RUM, błędów JavaScript, monitoringu API i lejków w jednym narzędziu z jednym skryptem. Monitoring błędów pochodzi od zespołu TrackJS, który zajmuje się tym od lat.
- Spędzasz większość czasu nad Long Animation Frames i zależy ci na osobnym dashboardzie LoAF.
- Potrzebujesz raportów white-label dla klientów.
- Twoje dane muszą pozostać w Kanadzie albo potrzebujesz self-hostingu czy instancji na wyłączność.
- Twój serwis zmieści się w darmowym planie albo zespół potrzebuje nielimitowanej liczby kont w planie podstawowym.
- Chcesz skanów z Lighthouse i danych konkurencji z CrUX od pierwszego dnia, zanim cokolwiek zainstalujesz.
Przetestuj na własnej stronie
Najprościej porównać oba narzędzia, uruchamiając je równolegle na dwa tygodnie. Oba skrypty ładują się asynchronicznie i nie wchodzą sobie w drogę. Okres próbny CoreDash trwa 14 dni, nie wymaga karty kredytowej, a instalacja sprowadza się do jednego tagu script lub wtyczki do WordPressa. Sprawdź cennik albo umów 20-minutowe demo, a przejrzę twoje dane razem z tobą.
W przypadku innych narzędzi sprawdź wszystkie porównania CoreDash.
Źródła: cennik Request Metrics, dokumentacja cennika, limity ruchu, przewodnik po LoAF, przewodnik po LCP, przewodnik po CrUX, dokumentacja API browser agenta, dane użytkowników, ogłoszenie Unified Web Performance, zapowiedź Professor Sloth. Rozmiar agenta zmierzony na rm.js v2.4.1.